
主题
面试速答(先看这里)
**一句话结论:**长事务通常是指在数据库系统中,运行时间较长、执行时间跨度较大的事务。
60秒标准回答:
长事务通常是指在数据库系统中,运行时间较长、执行时间跨度较大的事务。 我们应该尽可能的避免长事务,主要由以下几个原因
1、 事务的执行时间长,就会持续占用数据库的连接。 因为数据库的连接数是有固定限制的,被长时间占用就会使得其他的事务无法获得连接,导致数据库的整体吞吐量下降
2、 事务中如果加了锁,那么锁会一直在事务中被持有 ,那么就会导致锁冲突多,导致数据库吞吐量下降,甚至可能会导致大量的死锁问题
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**1、 事务的执行时间长,就会持续占用数据库的连接。
- **要点2:**2、 事务中如果加了锁,那么锁会一直在事务中被持有 ,那么就会导致锁冲突多,导致数据库吞吐量下降,甚至可能会导致大量的死锁问题。
- **要点3:**在MySQL的官网中,提到了3个和长事务有关的问题:
- **要点4:**3、InnoDB使用MVCC来实现并发控制, 长事务会导致旧版本的数据持续存在 ,影响数据库的清理操作(如Purging),从而影响整体性能。
- **要点5:**4、当在长事务中修改或删除行时,如果其他使用 READ COMMITTED和 REPEATABLE READ隔离级别的事务读取这些相同的行,则它们必须做更多的工作来重建旧数据。
**记忆锚点:**READ → 行时间跨度较大的事务 → 该尽可能的避免长事务 → 用就会使得其他的事务 → REPEATABLE → 该尽可能的拆分长事务
关键取舍:
- 因为数据库的连接数是有固定限制的,被长时间占用就会使得其他的事务无法获得连接,导致数据库的整体吞吐量下降。
- 在MySQL的官网中,提到了3个和长事务有关的问题: 3、InnoDB使用MVCC来实现并发控制, 长事务会导致旧版本的数据持续存在 ,影响数据库的清理操作(如Purging),从而影响整体性能。
易错提醒:
- 我们应该尽可能的避免长事务,主要由以下几个原因: 1、 事务的执行时间长,就会持续占用数据库的连接。
- 所以我们应该尽可能的拆分长事务,在一个事务中,不要干太多的事儿,尤其是一些和数据库操作无关的内存计算、远程调用等等。
加分表达:
- 2、 事务中如果加了锁,那么锁会一直在事务中被持有 ,那么就会导致锁冲突多,导致数据库吞吐量下降,甚至可能会导致大量的死锁问题。
- 详见: 4、当在长事务中修改或删除行时,如果其他使用 READ COMMITTED和 REPEATABLE READ隔离级别的事务读取这些相同的行,则它们必须做更多的工作来重建旧数据。
追问准备:
- 围绕「READ」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「行时间跨度较大的事务」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「该尽可能的避免长事务」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
**长事务通常是指在数据库系统中,运行时间较长、执行时间跨度较大的事务。**我们应该尽可能的避免长事务,主要由以下几个原因:
1、**事务的执行时间长,就会持续占用数据库的连接。**因为数据库的连接数是有固定限制的,被长时间占用就会使得其他的事务无法获得连接,导致数据库的整体吞吐量下降。
2、事务中如果加了锁,那么锁会一直在事务中被持有,那么就会导致锁冲突多,导致数据库吞吐量下降,甚至可能会导致大量的死锁问题。
在MySQL的官网中,提到了3个和长事务有关的问题:
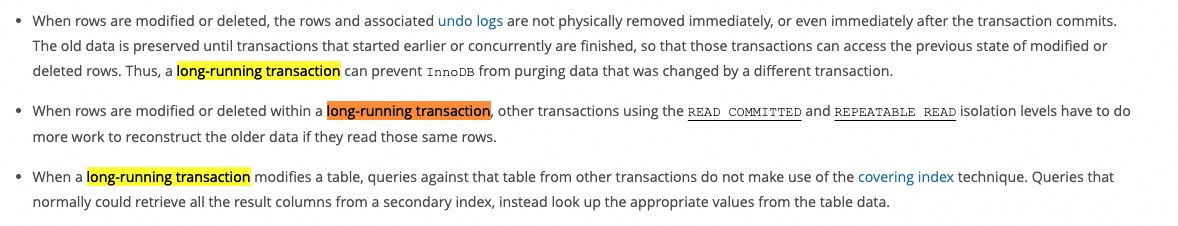
3、InnoDB使用MVCC来实现并发控制,长事务会导致旧版本的数据持续存在,影响数据库的清理操作(如Purging),从而影响整体性能。详见:
4、当在长事务中修改或删除行时,如果其他使用 READ COMMITTED和 REPEATABLE READ隔离级别的事务读取这些相同的行,则它们必须做更多的工作来重建旧数据。(这里主要指的是undolog的生成)
5、当一个长事务修改一个表时,可能会导致其他事务对该表的查询不使用覆盖索引技术。
详见:
所以我们应该尽可能的拆分长事务,在一个事务中,不要干太多的事儿,尤其是一些和数据库操作无关的内存计算、远程调用等等。以及一些普通的查询,也可以先在事务外查询,然后在更新的时候再开启事务。
所以,尽可能的使用编程式事务来代替声明式事务,因为声明式事务的粒度都是整个方法级别的,和容易导致长事务。