
主题
面试速答(先看这里)
**一句话结论:**首先,做了分库分表之后,所有的读和写操作,都需要带着分表字段,这样才能知道具体去哪个库、哪张表中去查询数据。
60秒标准回答:
分库分表之后,会带来很多问题
首先,做了分库分表之后,所有的读和写操作,都需要带着分表字段,这样才能知道具体去哪个库、哪张表中去查询数据。如果不带的话,就得支持全表扫描
但是,单表的时候全表扫描比较容易,但是做了分库分表之后,就没办法做扫表的操作了,如果要扫表的话就要把所有的物理表都要扫一遍
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**但是,单表的时候全表扫描比较容易,但是做了分库分表之后,就没办法做扫表的操作了,如果要扫表的话就要把所有的物理表都要扫一遍。
- **要点2:**还有,一旦我们要从多个数据库中查询或者写入数据,就有很多事情都不能做了,比如 跨库事务就是不支持的。
- **要点3:**所以,分库分表之后就会带来因为不支持事务而导致的数据一致性的问题。
- **要点4:**其次, 做了分库分表之后,以前单表中很方便的分页查询、排序等等操作就都失效了。
- **要点5:**除此之外,还有一些其他的问题,比如 二次分表的问题,一致性ID的问题 等等。
**记忆锚点:**而导致的数据一致性 → 跨库事务
易错提醒:
- 但是,单表的时候全表扫描比较容易,但是做了分库分表之后,就没办法做扫表的操作了,如果要扫表的话就要把所有的物理表都要扫一遍。
- 还有,一旦我们要从多个数据库中查询或者写入数据,就有很多事情都不能做了,比如 跨库事务就是不支持的。
加分表达:
- 如果不带的话,就得支持全表扫描。
追问准备:
- 围绕「而导致的数据一致性」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「跨库事务」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
分库分表之后,会带来很多问题。
首先,做了分库分表之后,所有的读和写操作,都需要带着分表字段,这样才能知道具体去哪个库、哪张表中去查询数据。如果不带的话,就得支持全表扫描。
但是,单表的时候全表扫描比较容易,但是做了分库分表之后,就没办法做扫表的操作了,如果要扫表的话就要把所有的物理表都要扫一遍。
还有,一旦我们要从多个数据库中查询或者写入数据,就有很多事情都不能做了,比如跨库事务就是不支持的。
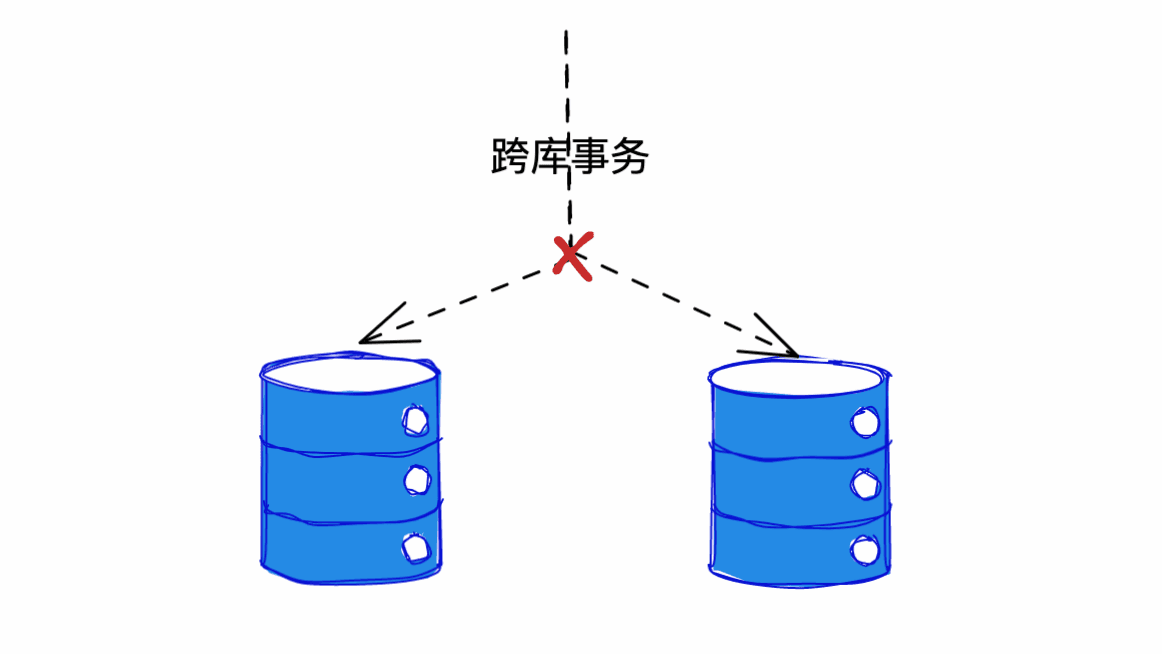
所以,分库分表之后就会带来因为不支持事务而导致的数据一致性的问题。
其次,做了分库分表之后,以前单表中很方便的分页查询、排序等等操作就都失效了。因为我们不能跨多表进行分页、排序。
除此之外,还有一些其他的问题,比如二次分表的问题,一致性ID的问题等等。
二次分表的问题可以用一致性哈希解决:
分布式ID可以参考: