
主题
面试速答(先看这里)
**一句话结论:**Zookeeper 负责管理 Kafka 集群中的所有 Broker,当有 Broker 加入或退出时,Zookeeper 负责通知其他组件,让 Kafka 及时更新集群信息。
60秒标准回答:
在上面的文章中我们介绍过Kafka的架构,这里面有个很关键的组件,是Zookeeper。( 但是后来被移除了,详见后文 )
ZooKeeper是Kafka集群中使用的分布式协调服务,用于维护Kafka集群的状态和元数据信息,例如主题和分区的分配信息、消费者组和消费者偏移量等。 展开说就是有以下这些功能
Zookeeper 负责管理 Kafka 集群中的所有 Broker,当有 Broker 加入或退出时,Zookeeper 负责通知其他组件,让 Kafka 及时更新集群信息
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **Controller选举:**Kafka 依赖 Zookeeper 来进行 Controller 选举 。
- **Broker配置信息:**Kafka中Broker 的一些配置信息(如主题的创建、删除、修改)可以存储在 Zookeeper 中,并由 Zookeeper 负责通知集群中的其他 Broker 进行更新。
**记忆锚点:**Kafka → Zookeeper → Broker → Controller → KRaft → Leader
关键取舍:
- 提升可扩展性 :Zookeeper 在大规模 Kafka 集群中的性能可能会成为瓶颈,而 KRaft 通过更高效的元数据管理方式提升了扩展能力。
加分表达:
- 在上面的文章中我们介绍过Kafka的架构,这里面有个很关键的组件,是Zookeeper。
- 如果 Broker 崩溃或断开连接,临时节点会自动删除,其他组件能感知到这个 Broker 不再可用。
- 如果当前 Controller 崩溃,Zookeeper 会帮助选出新的 Controller,以确保集群正常运行。
追问准备:
- 围绕「Kafka」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「Zookeeper」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「Broker」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
在上面的文章中我们介绍过Kafka的架构,这里面有个很关键的组件,是Zookeeper。(但是后来被移除了,详见后文)
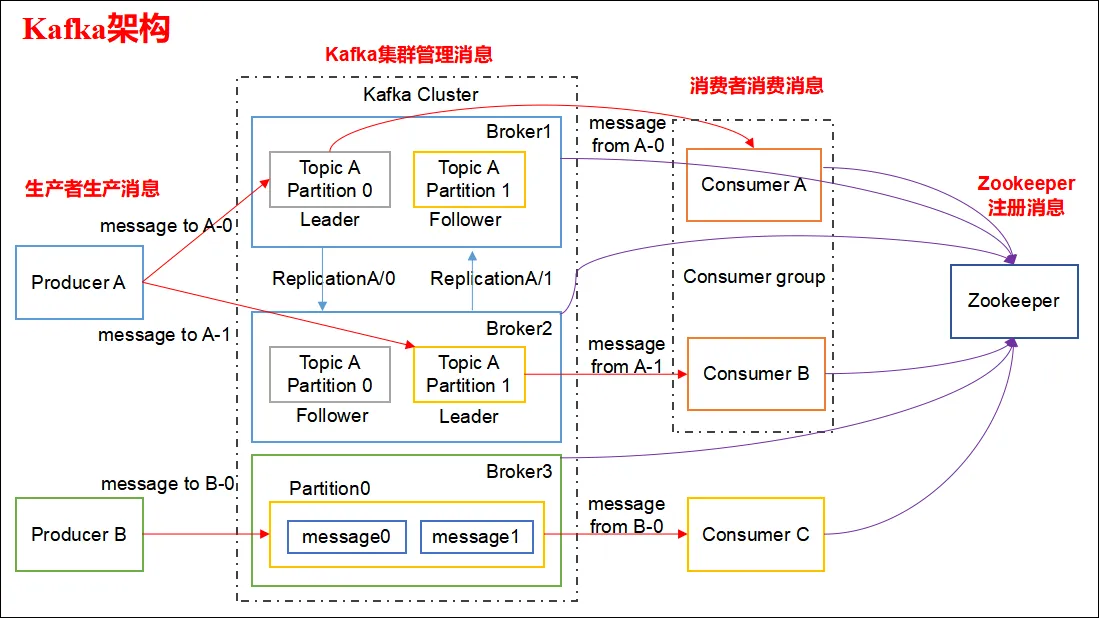
ZooKeeper是Kafka集群中使用的分布式协调服务,用于维护Kafka集群的状态和元数据信息,例如主题和分区的分配信息、消费者组和消费者偏移量等。 展开说就是有以下这些功能:
集群管理
Zookeeper 负责管理 Kafka 集群中的所有 Broker,当有 Broker 加入或退出时,Zookeeper 负责通知其他组件,让 Kafka 及时更新集群信息。
实现原理:当 Kafka 的 Broker 启动时,会在 Zookeeper 创建一个临时节点。如果 Broker 崩溃或断开连接,临时节点会自动删除,其他组件能感知到这个 Broker 不再可用。
plain
/brokers/ids/{broker_id}该节点会存储 Broker 的 host、port 信息,这样其他 Broker 或客户端可以从 Zookeeper 获取 Broker 列表。
分区和副本管理
kafka的数据存储是基于分区和副本的,zk则负责存储这些分区的元数据,包括:
- 该分区有哪些副本(Replicas)
- 哪个副本是 Leader,哪些是 Follower
- 副本的 ISR(In-Sync Replica,即同步副本集合)列表
实现原理: Kafka 在 /brokers/topics/{topic_name}/partitions/{partition_id}/state 目录下存储每个分区的 Leader、副本、ISR(In-Sync Replica)列表。
plain
/brokers/topics/topic1/partitions/0/state存储内容大致为:
plain
{
  "leader": 1001,
  "replicas": [1001, 1002, 1003],
  "isr": [1001, 1002]
}Broker 会监听监听这个节点,当 Leader 发生变化时,Kafka 通过 Zookeeper 通知所有相关 Broker 更新 Leader 信息。
Controller选举
Kafka 依赖 Zookeeper 来进行 Controller 选举。Controller 负责管理整个 Kafka 集群中的Partition和副本(Replica)。如果当前 Controller 崩溃,Zookeeper 会帮助选出新的 Controller,以确保集群正常运行。
实现原理:当要开始进行Controller 选举时,每个 Broker 争抢创建 /controller 节点。第一个成功创建 **/controller** 节点的 Broker 就成为 Controller。当 Controller 崩溃时,Zookeeper 立即删除该临时节点,其他 Broker 重新发起选举。
Broker配置信息
Kafka中Broker 的一些配置信息(如主题的创建、删除、修改)可以存储在 Zookeeper 中,并由 Zookeeper 负责通知集群中的其他 Broker 进行更新。
扩展知识
zk被移除
从 Kafka 2.8.0 开始,Kafka 引入了 KRaft(Kafka Raft)协议,尝试摆脱对 Zookeeper 的依赖。主要目的是:
- 减少依赖,简化运维:Zookeeper 需要单独部署和维护,使用自己的KRaft,可以直接管理元数据,降低系统复杂度。
- 提升可扩展性:Zookeeper 在大规模 Kafka 集群中的性能可能会成为瓶颈,而 KRaft 通过更高效的元数据管理方式提升了扩展能力。
- 加快故障恢复:KRaft 采用 Raft 选举方式,相比 Zookeeper 选举 Controller 速度更快,提高了 Kafka 的可用性。
在2025-3-19日,Kafka 4.0发布后(https://archive.apache.org/dist/kafka/4.0.0/RELEASE_NOTES.html ),则默认采用KRaft模型运行,不再依赖Zk。