
主题
面试速答(先看这里)
**一句话结论:**如果你看过布隆过滤器的实现原理,那么就应该知道,他能占用多少内存,不仅仅取决于他要存多少数据进去,还取决于你设置的误判率是多少,以及你设置的bitset的长度,以及用到的hash函数的个数。
60秒标准回答:
如果你看过布隆过滤器的实现原理,那么就应该知道,他能占用多少内存,不仅仅取决于他要存多少数据进去,还取决于你设置的误判率是多少,以及你设置的bitset的长度,以及用到的hash函数的个数
每一个数据指标不一样最终的结果可能都不一样的。肯定是误判率越低,占的内存越大了
有一个比较通用的内存估算公式
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**每一个数据指标不一样最终的结果可能都不一样的。
- **要点2:**布隆过滤器的内存占用(位数组大小 m )与元素数量 n 和预期误判率 p 满足以下关系:
- **要点3:**公式推导过程: ,就不展开写了,大家可以去看下。
- **要点4:**假设存储5亿数据,误判率是0.001,那么:n = 500000000,p=0.001,那么ln(0.001)=−6.9078,(ln2)^2=0.4805,带入公式:
- **要点5:**这么多个bit转成G的话,那么就是 7187304890.74/8/1024/1024/1024 = 0.836G
**记忆锚点:**bit → developeraliyuncom → 5亿条数据放到布隆过滤器中 → article → bitset → https
加分表达:
- 如果你看过布隆过滤器的实现原理,那么就应该知道,他能占用多少内存,不仅仅取决于他要存多少数据进去,还取决于你设置的误判率是多少,以及你设置的bitset的长度,以及用到的hash函数的个数。
- m : 位数组大小(单位:bit) p: 预期误判率 假设存储5亿数据,误判率是0.001,那么:n = 500000000,p=0.001,那么ln(0.001)=−6.9078,(ln2)^2=0.4805,带入公式: 这么多个bit转成G的话,那么就是 7187304890.74/8/1024/1024/1024 = 0.836G 那么总结下, 如果是…
追问准备:
- 围绕「bit」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「developeraliyuncom」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「5亿条数据放到布隆过滤器中」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
如果你看过布隆过滤器的实现原理,那么就应该知道,他能占用多少内存,不仅仅取决于他要存多少数据进去,还取决于你设置的误判率是多少,以及你设置的bitset的长度,以及用到的hash函数的个数。
每一个数据指标不一样最终的结果可能都不一样的。肯定是误判率越低,占的内存越大了。
有一个比较通用的内存估算公式:
布隆过滤器的内存占用(位数组大小 **m**)与元素数量 **n** 和预期误判率 **p** 满足以下关系:
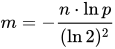
公式推导过程:https://developer.aliyun.com/article/743706 ,就不展开写了,大家可以去看下。
- m: 位数组大小(单位:bit)
- n: 元素数量
- p: 预期误判率
假设存储5亿数据,误判率是0.001,那么:n = 500000000,p=0.001,那么ln(0.001)=−6.9078,(ln2)^2=0.4805,带入公式:
0.4805
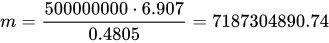
这么多个bit转成G的话,那么就是 7187304890.74/8/1024/1024/1024 = 0.836G
那么总结下,如果是千分之一的误判率,5亿数据占用内存大概0.836G,既856M,如果误判率是百分之一的话,占用内存大概是0.557G,既571M。