
主题
面试速答(先看这里)
**一句话结论:**在这个日志的上下文不远处就定位到这条慢SQL:
60秒标准回答:
线上有一个反欺诈相关的定时任务执行连续多次失败
于是紧急排查日志,发现在任务执行的时间段,有大量报错
在这个日志的上下文不远处就定位到这条慢SQL
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**线上有一个反欺诈相关的定时任务执行连续多次失败:
- **要点2:**这条SQL的主要目的是找到是否有买卖家之间存在关联关系的数据。
- **要点3:**通过这个执行计划可以发现,type = index ,extra = Using where; Using index ,表示SQL因为不符合最左前缀匹配,而扫描了整颗索引树,故而很慢。
- **要点4:**定位到问题之后,那解决起来就很简单了,只需要增加正确的索引或者修改SQL就行了。
- **要点5:**可以看到,type=ref,说明用到了普通索引,你并且rows也变少了,整个SQL大大提升了查询速度,任务失败的问题得到解决。
**记忆锚点:**Using → SQL → index → type → idx_byr_slr_product → where
易错提醒:
- 线上有一个反欺诈相关的定时任务执行连续多次失败: 于是紧急排查日志,发现在任务执行的时间段,有大量报错: 在这个日志的上下文不远处就定位到这条慢SQL: 这条SQL的主要目的是找到是否有买卖家之间存在关联关系的数据。
- 于是修改表结构,增加新的索引: 经过修改后,再执行以下执行计划: select_type fraud_risk_case partitions possible_keys idx_byr_slr_product,idx_subject_type_product_user idx_subject_type_product_user const,const fi…
追问准备:
- 围绕「Using」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「SQL」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「index」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
问题发现
线上有一个反欺诈相关的定时任务执行连续多次失败:
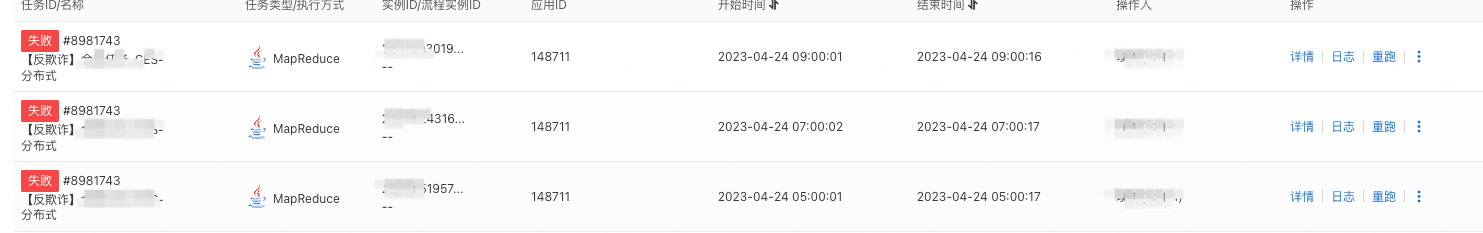
于是紧急排查日志,发现在任务执行的时间段,有大量报错:
plain
Cause: ERR-CODE: [TDDL-4202][ERR_SQL_QUERY_TIMEOUT] Slow query leads to a timeout exception, please contact DBA to check slow sql. SocketTimout:12000 ms,在这个日志的上下文不远处就定位到这条慢SQL:
plsql
select distinct buyer_id as buyerId, seller_id as sellerId from fraud_risk_case WHERE subject_id_enum = 'BUYER_SELLER_BOTH' and (buyer_id = ? or seller_id = ? ) and product_type_enum = ? order by id desc limit 100这条SQL的主要目的是找到是否有买卖家之间存在关联关系的数据。
通过执行explain,我们看了一下执行计划:
| id | 1 |
|---|---|
| select_type | SIMPLE |
| table | fraud_risk_case |
| partitions | NULL |
| type | index |
| possible_keys | idx_byr_slr_product |
| key | idx_byr_slr_product |
| key_len | 1546 |
| ref | NULL |
| rows | 4133627 |
| filtered | 0.19 |
| Extra | Using where; Using index |
通过这个执行计划可以发现,type = index ,extra = Using where; Using index ,表示SQL因为不符合最左前缀匹配,而扫描了整颗索引树,故而很慢。
于是查看这张表的建表语句,确实存在subject_id_enum和product_type_enum字段的联合索引,但是这个字段并不是前导列:
plsql
idx_subject_product(subject_id,subject_id_enum,product_type)问题解决
定位到问题之后,那解决起来就很简单了,只需要增加正确的索引或者修改SQL就行了。于是修改表结构,增加新的索引:
plsql
ALTER TABLE `fraud_risk_case`
ADD KEY `idx_subject_type_product_user` (`subject_id_enum`,`product_type_enum`,`buyer_id`,`seller_id`);经过修改后,再执行以下执行计划:
| id | 1 |
|---|---|
| select_type | SIMPLE |
| table | fraud_risk_case |
| partitions | NULL |
| type | ref |
| possible_keys | idx_byr_slr_product,idx_subject_type_product_user |
| key | idx_subject_type_product_user |
| key_len | 516 |
| ref | const,const |
| rows | 1 |
| filtered | 19.00 |
| Extra | Using where; Using index; Using temporary; Using filesort |
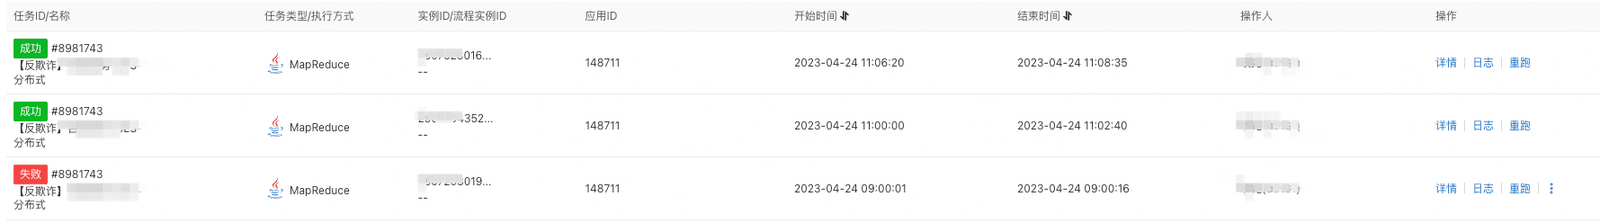
可以看到,type=ref,说明用到了普通索引,你并且rows也变少了,整个SQL大大提升了查询速度,任务失败的问题得到解决。
参考: