
主题
面试速答(先看这里)
**一句话结论:**LRU只关注数据最近一次被使用时间(时间越久、越容易被淘汰),LFU 只关注数据最近一段时间被使用的次数(次数越少,越容易被淘汰)。
60秒标准回答:
LRU(The Least Recently Used),最近最少使用,最久未被访问的数据会被最早淘汰
LFU(Least Frequently Used),最少频次使用,访问次数最少的数据会被最早淘汰
LRU只关注数据最近一次被使用时间(时间越久、越容易被淘汰),LFU 只关注数据最近一段时间被使用的次数(次数越少,越容易被淘汰)
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**LRU(The Least Recently Used),最近最少使用,最久未被访问的数据会被最早淘汰。
- **要点2:**LFU(Least Frequently Used),最少频次使用,访问次数最少的数据会被最早淘汰。
- **要点3:**那么,如果按照LRU 淘汰的是,就淘汰那个最近一次使用时间更早的。
- **要点4:**如果按照LFU 淘汰的是,就淘汰那个使用次数最少的。
- **要点5:**LRU(The Least Recently Used,最近最少使用)是一种常见的缓存算法,在很多分布式缓存系统(如Redis, Memcached)中都有广泛使用。
**记忆锚点:**LFU → LRU → Least → Used → Frequently → Recently
易错提醒:
- LRU只关注数据最近一次被使用时间(时间越久、越容易被淘汰),LFU 只关注数据最近一段时间被使用的次数(次数越少,越容易被淘汰)。
加分表达:
- 假设缓存中数据使用顺序如下(从左到右表示时间从晚到早): A、B、C、D、A、C、C、D 那么,如果按照LRU 淘汰的是,就淘汰那个最近一次使用时间更早的。
- 即D 如果按照LFU 淘汰的是,就淘汰那个使用次数最少的。
- LRU算法的思想是:如果一个数据在最近一段时间没有被访问到,那么可以认为在将来它被访问的可能性也很小。
追问准备:
- 围绕「LFU」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「LRU」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「Least」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
LRU(The Least Recently Used),最近最少使用,最久未被访问的数据会被最早淘汰。
LFU(Least Frequently Used),最少频次使用,访问次数最少的数据会被最早淘汰。
LRU只关注数据最近一次被使用时间(时间越久、越容易被淘汰),LFU 只关注数据最近一段时间被使用的次数(次数越少,越容易被淘汰)。
假设缓存中数据使用顺序如下(从左到右表示时间从晚到早):
A、B、C、D、A、C、C、D
那么,如果按照LRU 淘汰的是,就淘汰那个最近一次使用时间更早的。即D
如果按照LFU 淘汰的是,就淘汰那个使用次数最少的。即B
LRU
LRU(The Least Recently Used,最近最少使用)是一种常见的缓存算法,在很多分布式缓存系统(如Redis, Memcached)中都有广泛使用。
LRU算法的思想是:如果一个数据在最近一段时间没有被访问到,那么可以认为在将来它被访问的可能性也很小。因此,当空间满时,最久没有访问的数据最先被淘汰。
最常见的实现是使用一个链表保存缓存数据,详细算法实现如下:
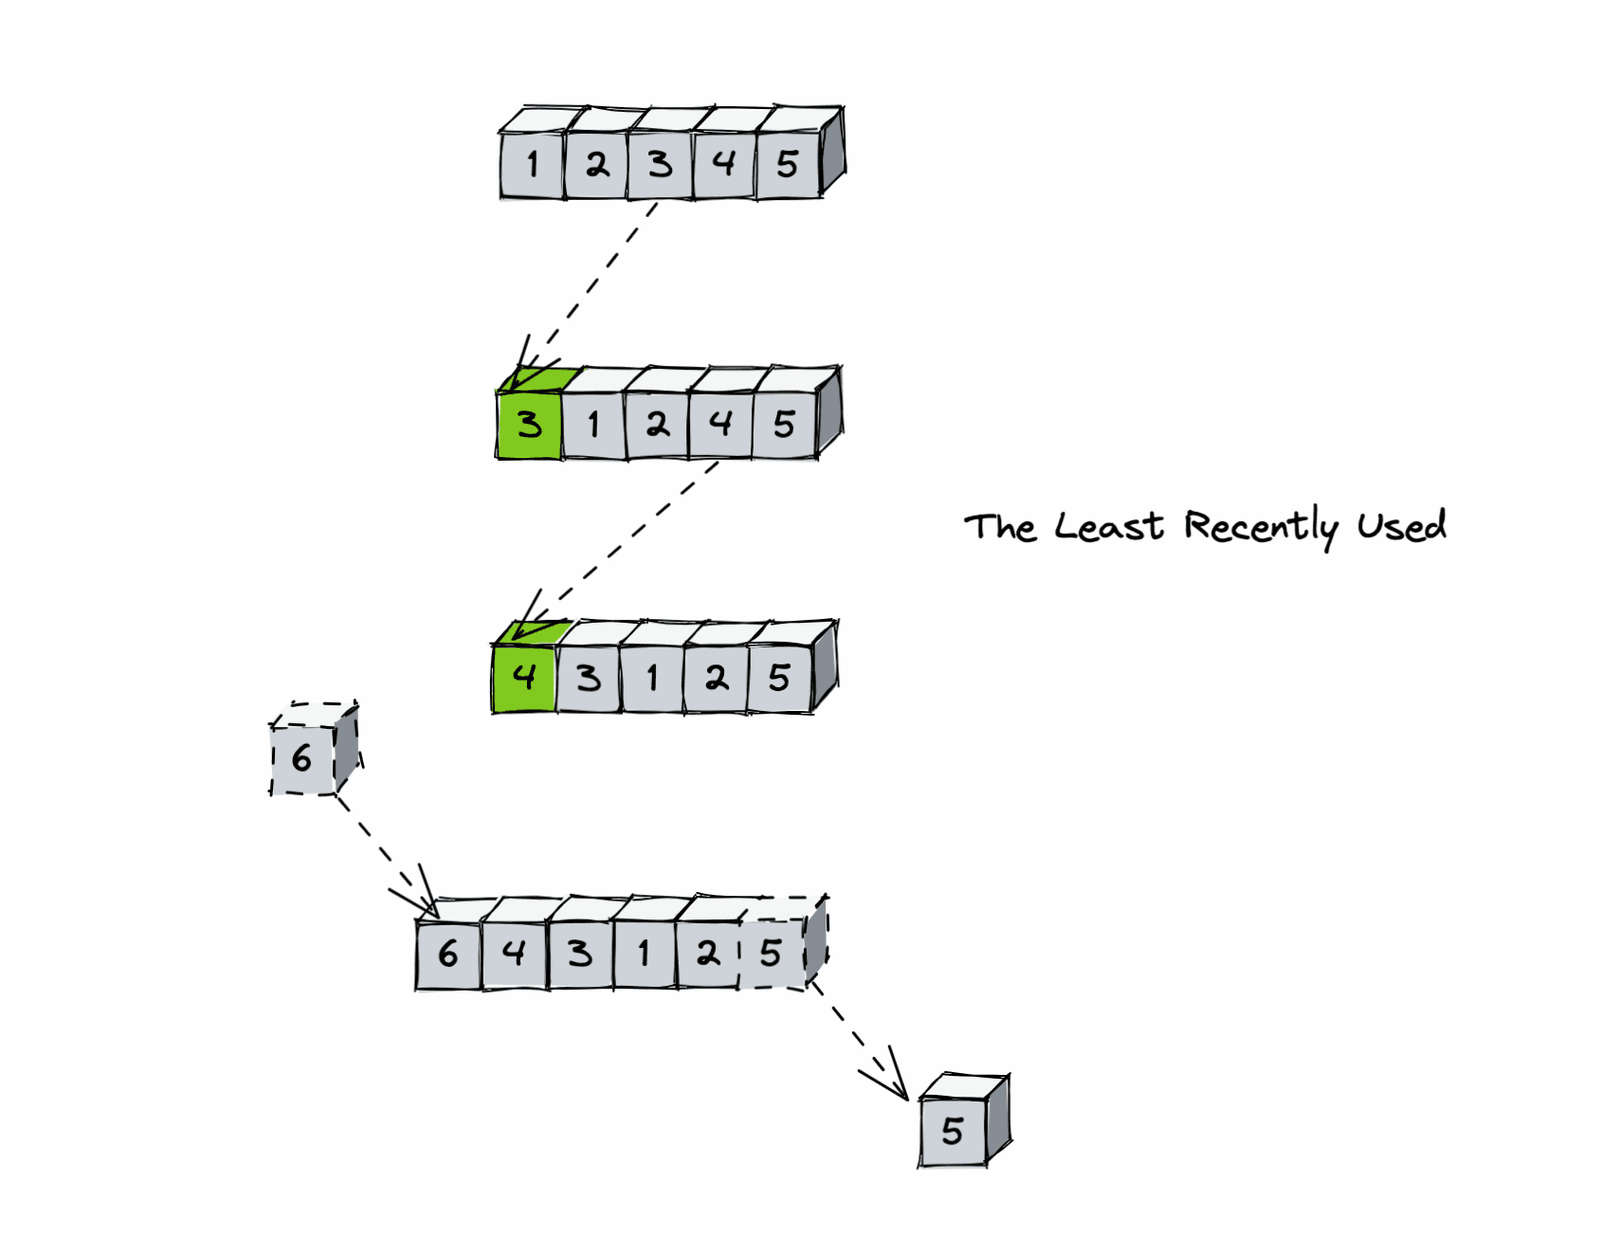
1. 新数据插入到链表头部;
2. 每当缓存命中,则将数据移到链表头部;
3. 当链表满的时候,将链表尾部的数据丢弃。
LFU
LFU(Least Frequently Used ,最少频次使用)也是一种常见的缓存算法。
顾名思义,LFU算法的思想是:如果一个数据在最近一段时间很少被访问到,那么可以认为在将来它被访问的可能性也很小。因此,当空间满时,最小频率访问的数据最先被淘汰。
LFU的每个数据块都有一个引用计数,所有数据块按照引用计数排序,具有相同引用计数的数据块则按照时间排序。
具体实现如下:
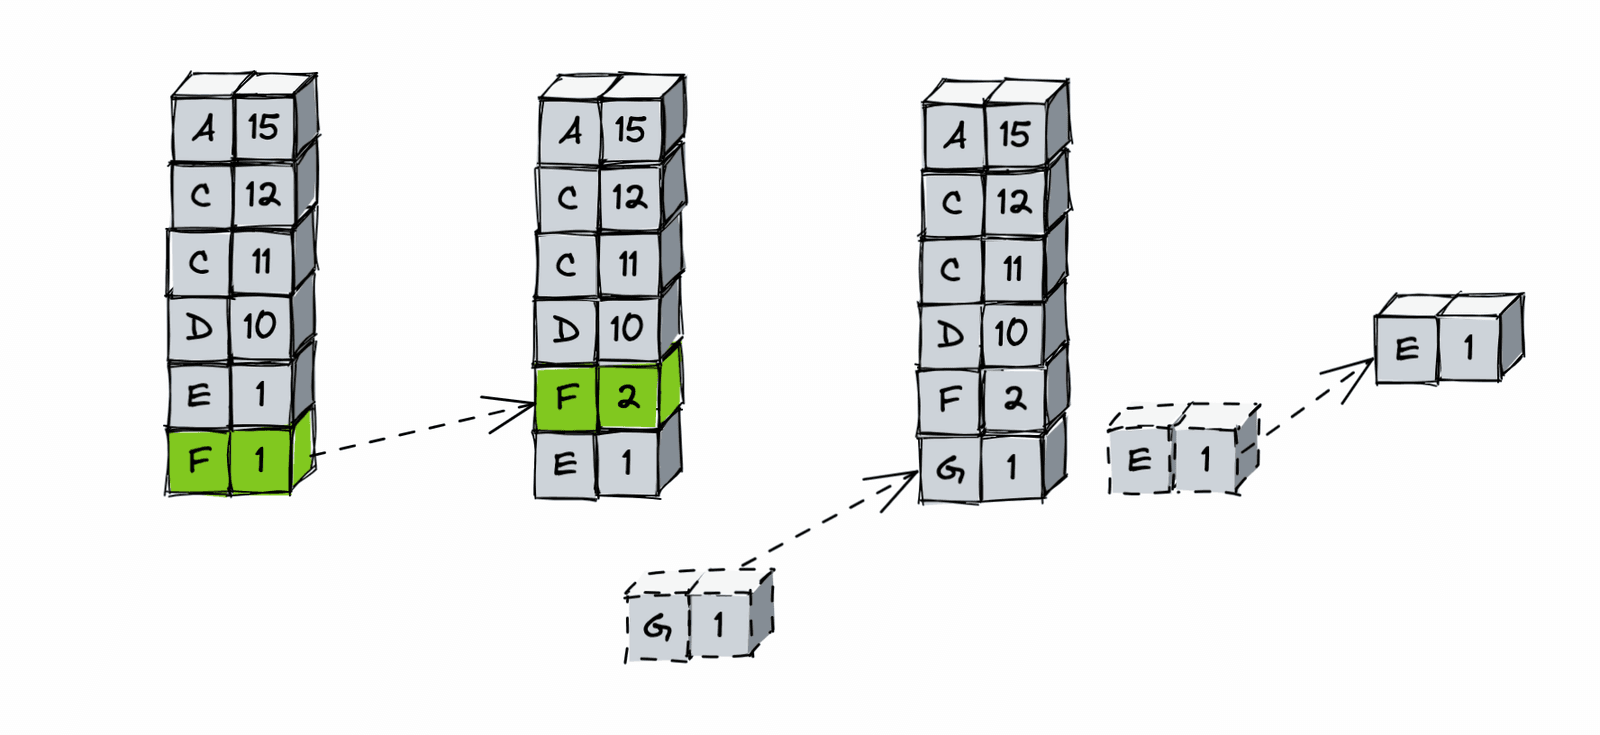
1. 新加入数据插入到队列尾部(因为引用计数为1);
2. 队列中的数据被访问后,引用计数增加,队列重新排序;
3. 当需要淘汰数据时,将已经排序的列表最后的数据块删除。